Data Engineering
Data engineering builds and operates the pipelines, storage, and validation systems that make data usable.
Follow databases, streaming and batch pipelines, lakehouses, and data quality. Coverage looks at how teams move, store, transform, and maintain data for analytics and AI.
Latest coverage
Articles
 News
Databricks Connects AWS HealthLake Data Through OpenSharing
 News
AWS documents SageMaker AI data preparation workflows
 News
Snowflake opens live Iceberg data to external REST Catalog clients
 News
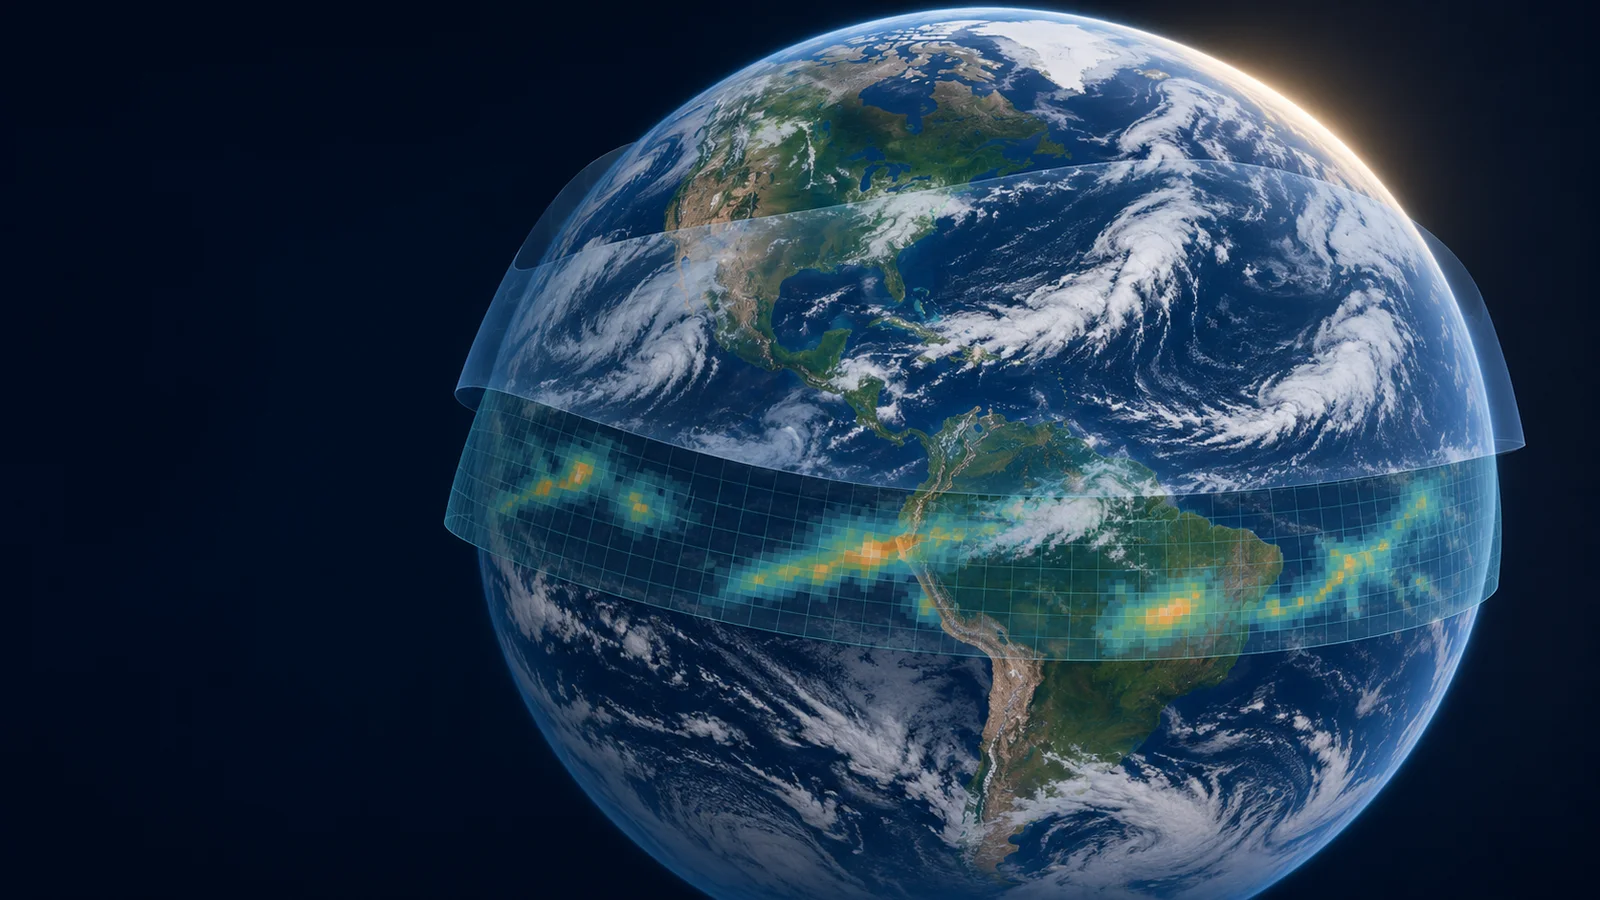
Google DeepMind opens PARDIG and SatWeave weather datasets
 News
Databricks adds push-based CDC path into Unity Catalog
 News
GS Caltex puts SageMaker Canvas models into production pipelines
 News
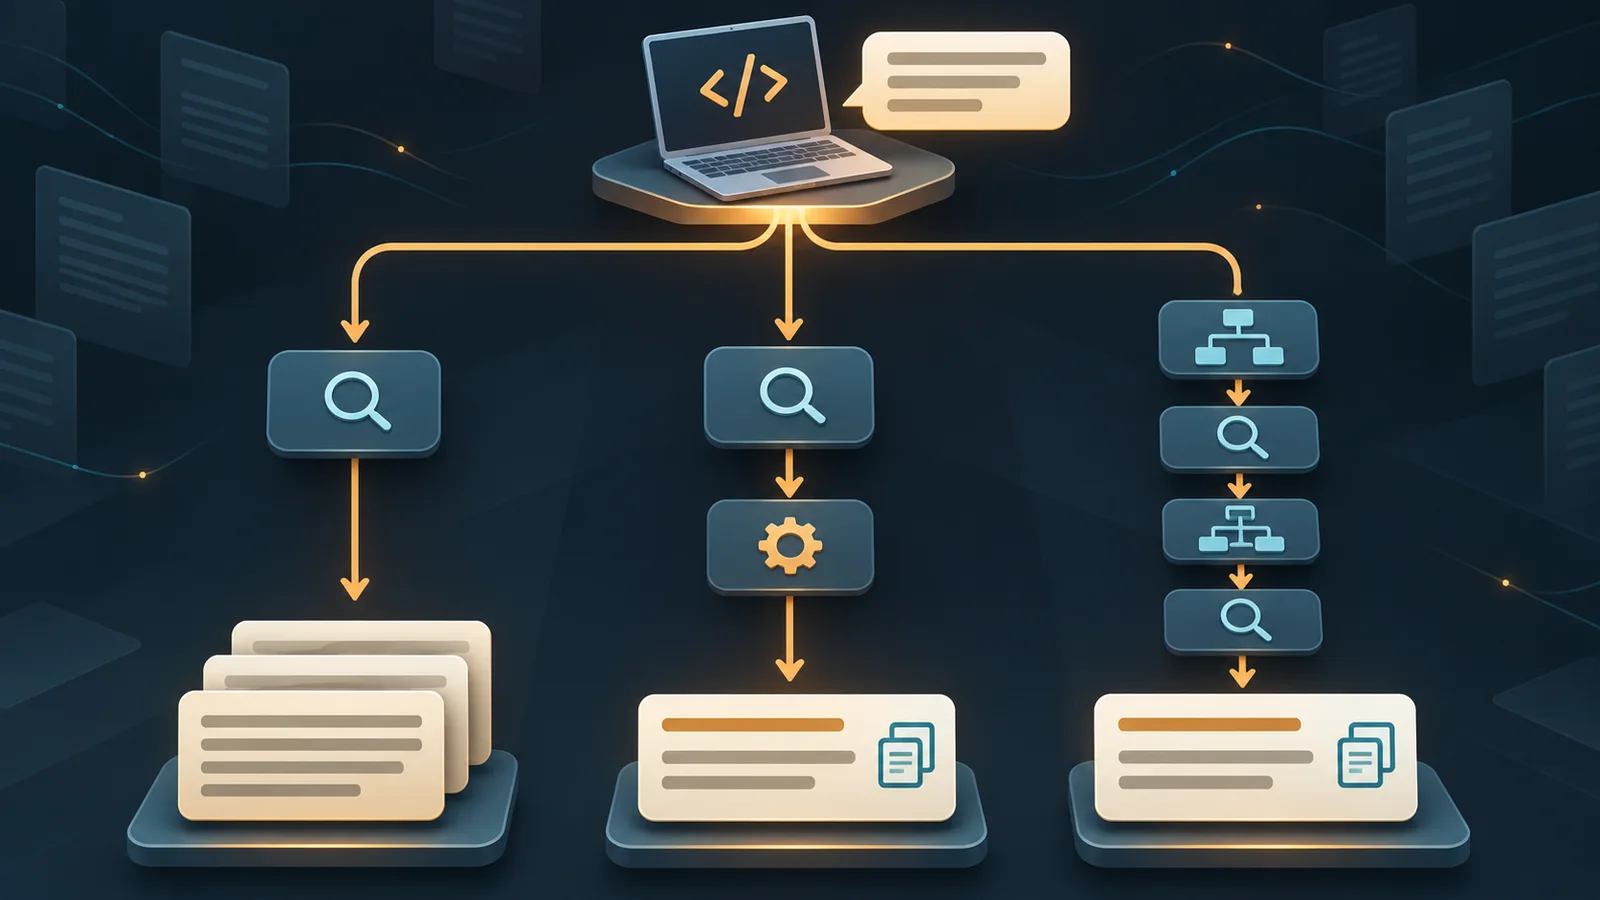
AWS adds single-shot and retrieval-only modes to Bedrock knowledge bases
 News
Confluent launches Streamhouse and makes Lightning Tables available on AWS
 News
Oracle sets 12-month window for AI Lakehouse semantic layer
 News
Databricks adds Unity Catalog metric views to Power BI in private preview
 News
AWS details how HyperPod data capture feeds model workflows
 News
Databricks makes Apache Spark 4.3 available in Runtime 19
Videos
 55:14
Gen AI data chain at scale
 Dmytro Spodarets·Nov 17, 2023
 53:52
LlamaIndex: How to use LLMs to Interface with Multiple Data Sources
Dmytro Spodarets·Aug 7, 2023 32:35
Rise in the use of synthetic data for regulated industries
Dmytro Spodarets·Jul 31, 2023 55:02
Why you should move to a Lakehouse
Dmytro Spodarets·May 29, 2023 47:37
Webinar "The promising role of synthetic data to enable responsible innovation"
Dmytro Spodarets·Mar 2, 2023 0:00
Webinar "Pachyderm in production: lessons learned" (RU)
Dmytro Spodarets·Oct 1, 2021 55:46
Webinar "Re-usable pipelines for ML projects with DVC" (RU)
Dmytro Spodarets·Sep 17, 2021